# Spark-X2.5 模型介绍
星火模型是科大讯飞自研的大语言模型系列,当前平台已上线 Spark X2.5 系列三款模型:
# 1、Spark X2.5
基于全国产平台训练,采用 MoE 架构,总参数 293B、激活参数 30B,支持 256K 上下文长度,全面提升代码生成与智能体(Agent)能力,同时覆盖 200 余种语言,在语言理解、知识问答、逻辑推理等通用任务上保持优异效果,适用于复杂推理、长文本处理与企业级应用。
下表为 Spark-X2.5 与多款前沿大模型的基准测试横向对比,从代码开发、Agent 自主执行、数理科学推理三大能力域进行量化评估。
| Benchmarks | GPT-5.6 Sol | Fable 5 | Claude Opus 4.8 | DeepSeek-V4-Pro-0813 | DeepSeek-V4-Flash-0731 | GLM-5.3 | GLM-5.2 | Spark-X2.5 |
|---|---|---|---|---|---|---|---|---|
| Coding | ||||||||
| SWE Verified | 96.2 | 95.0 | 88.6 | 92.0 | 88.8 | 91.0 | 81.0 | 89.0 |
| SWE Multilingual | 85.1 | 87.0 | 84.4 | 93.0 | 93.3 | 90.3 | 79.0 | 84.0 |
| SWE Pro | 64.6 | 80.0 | 69.2 | 74.8 | 69.1 | 68.2 | 62.1 | 67.5 |
| SciCode | 57.0 | 61.0 | 54.0 | 51.0 | 50.0 | 59.0 | 51.0 | 54.2 |
| Terminal Bench 2.1 | 88.0 | 85.0 | 85.0 | 87.9 | 82.7 | 88.2 | 81.0 | 70.0 |
| Agent | ||||||||
| τ³-bench | 44.3 | 38.1 | 34.2 | 39.6 | 39.4 | 50.3 | 35.6 | 38.2 |
| MCP-Atlas | 83.6 | 84.7 | 83.6 | 79.8 | 78.2 | 79.6 | 77.0 | 70.3 |
| WideSearch | 84.0 | 81.2 | 72.9 | 54.7 | 53.8 | 48.7 | 48.7 | 42.6 |
| STEM & General | ||||||||
| GPQA-Diamond | 94.1 | 92.6 | 92.0 | 92.8 | 90.8 | 91.7 | 91.2 | 91.0 |
| IMO-AnswerBench | 93.5 | 89.7 | 83.5 | 94.8 | 91.8 | 74.7 | 91.0 | 89.0 |
| AA-LCR | 84.0 | 82.3 | 77.7 | 80.3 | 78.3 | 79.7 | 78.9 | 77.0 |
| FrontierScience-Olympiad | 77.2 | 75.5 | 74.3 | 71.0 | 71.0 | 70.0 | 72.5 | 71.0 |
# 2、Spark X2.5-1.7B
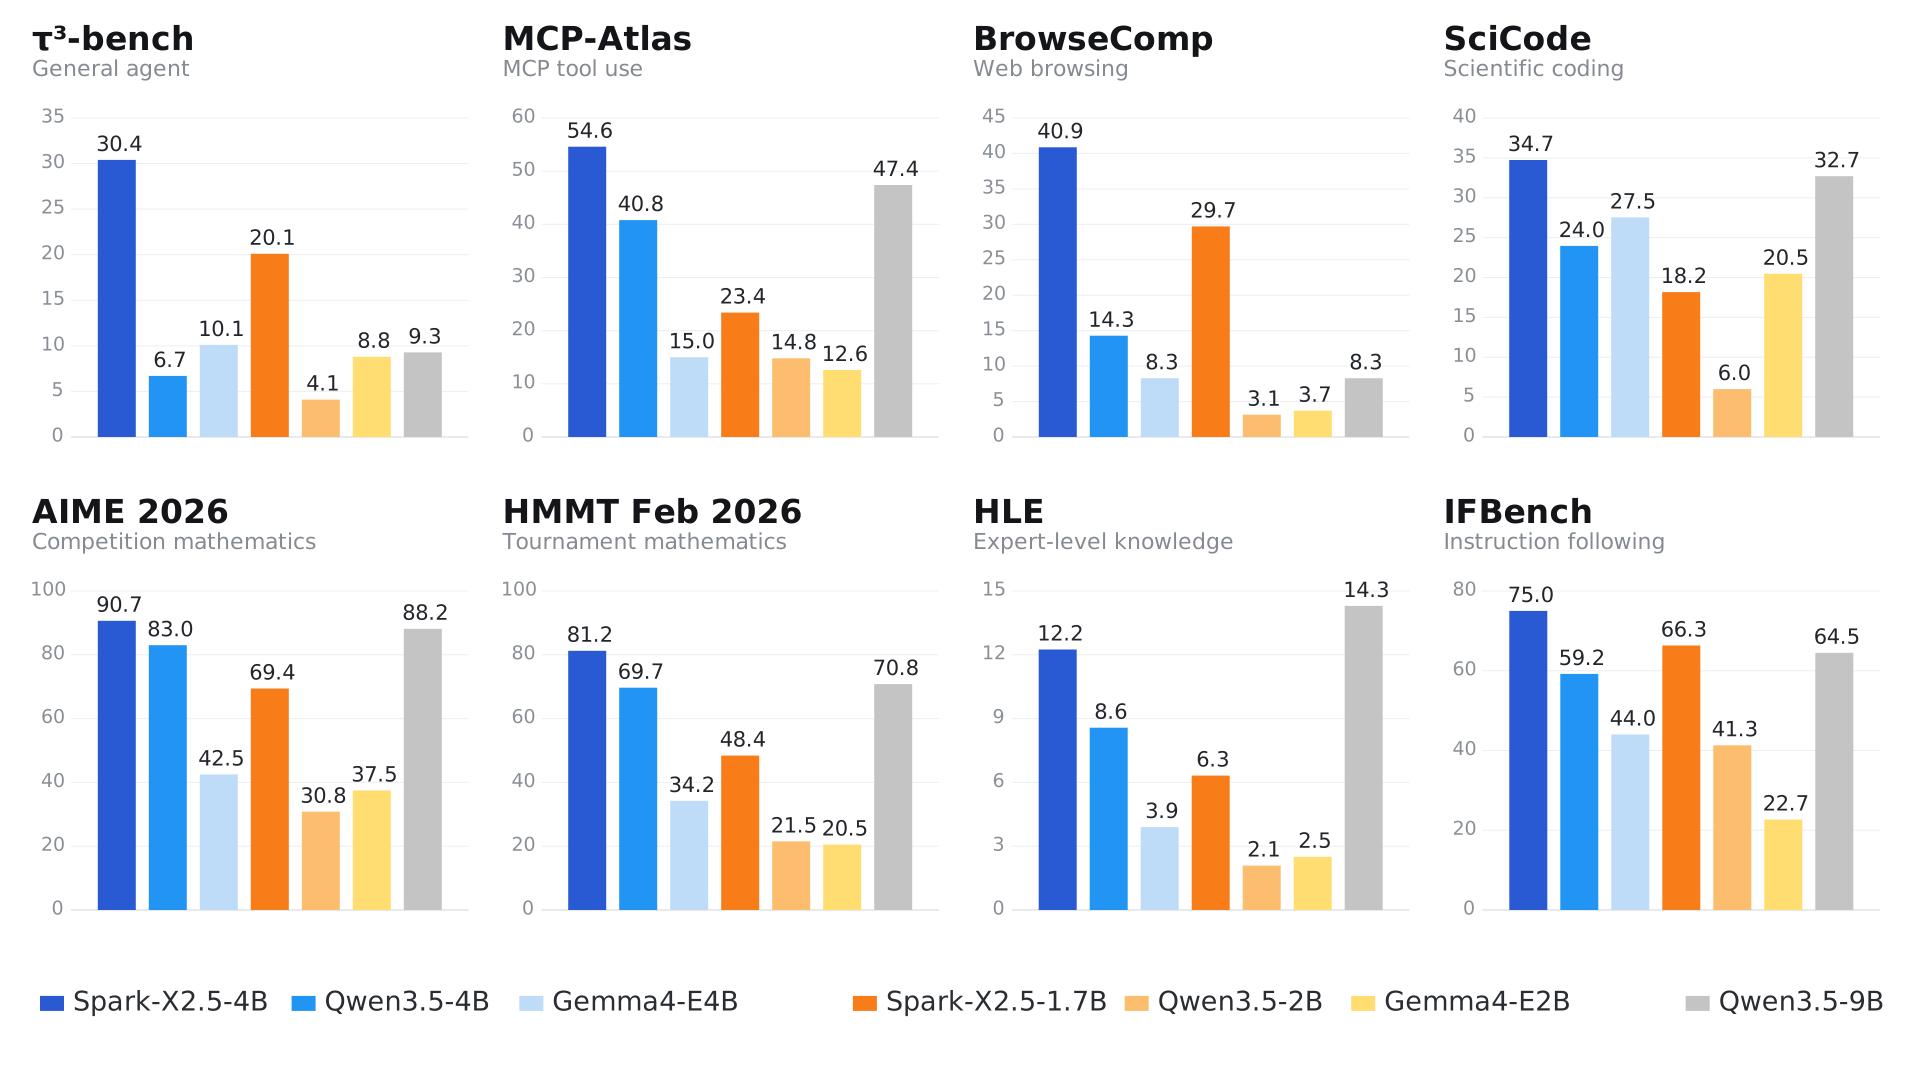
1.7B 级轻量端侧通用语言 Dense 模型,采用混合注意力架构,原生支持最长 1M token 上下文,支持 200 多种语言,在语言理解、文本创作、数学推理、编程、工具调用和智能体工作流等日常任务中表现优异,性能领先同尺寸开源模型,适合对时延与成本敏感的端侧及轻量级部署场景。
# 3、Spark X2.5-4B
4B 级端侧通用语言 Dense 模型,采用混合注意力架构,原生支持最长 1M token 上下文,支持 200 多种语言,在语言理解、文本创作、数学推理、编程、工具调用和智能体工作流等日常任务中表现优异,性能领先同尺寸开源模型,兼顾能力与效率,适合中小规模业务的快速接入。
# 快速调用
| 模型名称 | Model ID | 支持功能 | 上下文长度 | 输入模态 | 输出模态 | 上架时间 |
|---|---|---|---|---|---|---|
| Spark X2.5 | spark-x2.5 | 体验、API调用 | 256K | 文本 | 文本 | 2026/9/6 |
| Spark X2.5-1.7B | spark-x2.5-1.7b | 体验、API调用、精调 | 1M | 文本 | 文本 | 2026/8/31 |
| Spark X2.5-4B | spark-x2.5-4b | 体验、API调用、精调 | 1M | 文本 | 文本 | 2026/8/31 |
在这篇文章中:


